LLM etaloni vienkāršā valodā: ko nozīmē AI modeļu skaitļi
Katru dienu AI ziņās parādās skaitļi: «99,9 ARC-AGI-3», «97,6 % FrontierMath Tier 4», «55,8 Terminal-Bench», «0,75 $ par miljonu tokenu». Ja lasi mūsu dienas AI apskatus, šos skaitļus redzi katru rītu. Lielākā daļa cilvēku tos izlaiž — jo nav skaidrs, ko tie nozīmē. Šis raksts ir atslēga: vienkāršā valodā izskaidro, ko katrs etalons mēra, kā lasīt procentus un punktus, un — pats svarīgākais — kam pievērst uzmanību, izvēloties AI rīku savam darbam.
Kas ir etalons (benchmark) un kāpēc tas vispār vajadzīgs
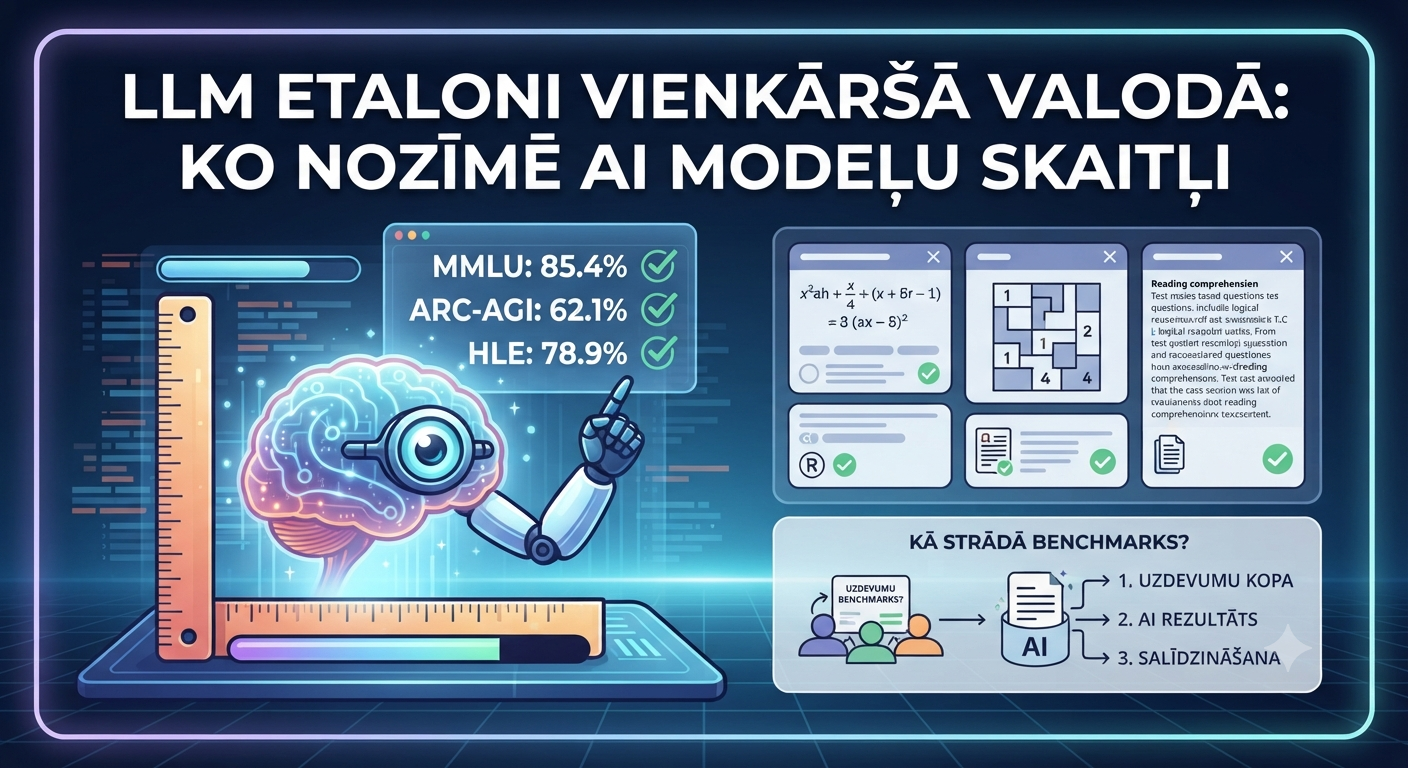
Etalons ir kā eksāmens. Kad skola grib pārbaudīt, vai skolēns prot matemātiku, tā nedod vienu jautājumu — tā dod pārbaudes darbu ar daudziem uzdevumiem, kuru pareizās atbildes skolotājs jau zina. AI etalons ir tas pats: sagatavota uzdevumu kopa ar zināmām atbildēm, ko modelim dod atrisināt, un tad mēra, cik atbildes ir pareizas.
Kāpēc tas vajadzīgs? Jo «AI ir gudrs» ir subjektīvi — divi cilvēki vienu modeli novērtēs pilnīgi atšķirīgi. Etalons dod kopīgu mēru, kā standartizēts eksāmens, lai var salīdzināt klases, skolas, valstis.
Trīs lietas, kas jāzina, pirms lasi jebkuru skaitli:
- Procents = daļa pareizi atrisināto uzdevumu. 99,9 % nozīmē «gandrīz viss pareizi», 50 % — «puse». Nekādas maģijas.
- Versijai ir nozīme. «ARC-AGI-3» nav tas pats, kas «ARC-AGI». Jaunāka versija parasti ir grūtāka — vecie uzdevumi jau «noplūda» modeļu treniņa datos, un tie kļuva pārāk viegli. Tāpēc 99,9 % jaunākajā versijā ir daudz iespaidīgāk nekā 99,9 % vecajā.
- Nedrīkst salīdzināt dažādu etalonu skaitļus savā starpā. «99,9 ARC-AGI» un «55,8 Terminal-Bench» nenozīmē, ka 99,9 ir «labāks» par 55,8 — tie mēra pilnīgi dažādas lietas uz dažādām skalām. Tas būtu kā salīdzināt temperatūru grādos ar svaru kilogramos.
Divas «skaitļu» ģimenes, ko cilvēki pastāvīgi jauc
AI modeļu skaitļi iedalās DIVĀS grupās:
- A. «Cik gudrs» — spēju etaloni — ARC-AGI, FrontierMath, HLE, OSWorld, Terminal-Bench. Tie mēra, ko modelis prot izdarīt.
- B. «Cik ērts un lēts» — praktiskie parametri — cena par tokenu, ātrums, konteksta logs, atmiņa. Tie mēra, cik viegli un izdevīgi modeli izmantot reālā darbā.
Pārdevējs tev vienmēr rādīs A sleju — «skat, cik gudrs!». Bet tavs rēķins un tavs laiks dzīvo B slejā. Nav jēgas maksāt par «visgudrāko modeli pasaulē», kas uz katru jautājumu domā 30 sekundes un izmaksā veselu bagātību, ja tev vajag ātri uzrakstīt e-pastu.
Spēju etaloni — ko katrs mēra
ARC-AGI — «vai tiešām saprot, nevis iegaumē»
ARC-AGI = Abstraction and Reasoning Corpus for AGI — aptuveni «abstrakcijas un spriešanas tests vispārīgajam mākslīgajam intelektam». To veidojis pētnieks Fransuā Šolē (François Chollet) ar vienu skaidru mērķi: pārbaudīt, vai modelis spēj saprast jaunu uzdevumu no dažiem piemēriem, nevis atsaukt atmiņā iegaumētu atbildi.
Kā tas izskatās: parādi modelim trīs mazas bildītes, kur sarkans kvadrāts katru reizi paslīd pa diagonāli, un saki — «uzzīmē ceturto». Pirmklasnieks izdomā likumu un atbild. Mākslīgajam intelektam tas bija ilgus gadus vissmagākais uzdevums pasaulē — ne tāpēc, ka bildītes grūtas, bet tāpēc, ka atbildi nav KO «atcerēties»: likums jāizsecina no nulles, un tieši tādas konfigurācijas treniņa datos nav bijis.
Kāpēc etalons ir tik prestižs: lielāko daļu vēstures modeļi tajā bija izmisīgi vāji. Vēl 2026. gada sākumā GPT-5.6 Sol dabūja aptuveni 7 % — praktiski «izgāzās». Kad GPT-6 Astra parādīja 99,9 %, tas bija tik liels lēciens, ka pēc tam sāka runāt par «AGI ēru».
Ko tas nozīmē tev: ja rīkam vajag reāli domāt ārpus ierastā — jauns, neparasts uzdevums, radošs risinājums, situācija bez precedenta — skaties uz ARC-AGI klasi. Ja uzdevums ir standarta, šis skaitlis tev maz ko pasaka.
MMLU — «skolas eksāmens»
MMLU = Massive Multitask Language Understanding. Vecākais un visplašāk lietotais vispārīgais tests: iedomājies, ka modelim vienā dienā jākārto gala pārbaudījums VISOS 57 priekšmetos vienlaikus — no vēstures līdz fizikai un tiesībām — ar testa jautājumiem un vairākiem atbilžu variantiem. Tā ir vistuvākā līdzība «gala eksāmenam» AI pasaulē.
Kad kāds saka «modelis zināšanās pārspēj cilvēku», parasti domā tieši MMLU un tamlīdzīgus enciklopēdiskos testus. Vērtība — ātrs vispārīgās erudīcijas momentuzņēmums.
Ierobežojums: uzdevumi ir ar zināmām, publiskām atbildēm, tātad modeļi tos daļēji «zina» no treniņa. Mūsdienās MMLU vairs nav kronis — tas ir pamata higiēnas rādītājs, atzīme, ko gandrīz visi jau prot dabūt.
HLE — «pēdējais eksāmens pirms AGI»
HLE = Humanity’s Last Exam — «cilvēces pēdējais eksāmens». Aptuveni 3000 jautājumu, ko sastādījuši zinātņu doktori — matemātiķi, ārsti, fiziķi — ar vienu nodevīgu mērķi: izgāzt pat labāko robotu. Neviens atsevišķs cilvēks tos visus nevar atbildēt — katrs eksperts pārvalda tikai savu šauro jomu; vidējs cilvēks — gandrīz neko.
Nosaukuma ideja: šim vajadzēja būt vienam no pēdējiem eksāmeniem, ko cilvēks vēl var «uzvarēt» pār mašīnu. Kad modeļi sāk to risināt labi, saraksts ar «cilvēka priekšrocībām» kļūst īss.
Ko tas nozīmē tev: praktiskajā izvēlē tieši neko. Tas ir «karstā jaunuma» rādītājs par to, cik tuvu laboratorijas ir savam AGI mērķim. Interesants ziņās, mazsvarīgs, kad izvēlies rīku ikdienai.
FrontierMath — «olimpiādes matemātika pētniekiem»
FrontierMath satur oriģinālus, nepublicētus matemātikas uzdevumus pētnieciskajā līmenī — kā olimpiāde, kuras mīklas izdomā tieši pirms eksāmena, lai atbildi nevarētu nedz iespīkot, nedz iemācīties no grāmatām. Modelis neko nevar «paturēt atmiņā» — jārisina no nulles.
«Tier» angliski ir «pakāpe, līmenis». «Tier 4» apzīmē stingrāko kategoriju. «97,6 % Tier 4» nozīmē: pat visgrūtākajos pētnieciskajos uzdevumos gandrīz viss pareizi.
Ko tas nozīmē tev: tieši neko, ja nemāci augstāko matemātiku. Bet netieši — matemātiska spriešana korelē ar loģisko domāšanu vispār, tāpēc spēcīgs rezultāts liecina par rīku, kuram var uzticēt sarežģītāku analīzi un aprēķinus.
OSWorld — «prot strādāt ar datoru kā cilvēks»
OSWorld mēra tā saucamo computer use — spēju vadīt datoru. Modelim iedod reālu virtuālo datoru (operētājsistēmu ar lietotnēm, failiem, pārlūku) un reālu uzdevumu, piemēram: «atver pārlūku, atrodi dokumentu, pārvieto to mapē un atsūti e-pastu». Atbilde nav vārdos — tur ir peles rādītājs, kuru modelim pašam jākustina: viņš spiež pogas, velk failus, klikšķina, līdz darbs izdarīts.
«72,6 % OSWorld 2.0» nozīmē: gandrīz trīs no četriem šādiem reāliem darbiem modelis izdara pilnībā pats, bez palīdzības.
Ko tas nozīmē tev: šis ir vistiešākais rādītājs tam, ko nozīmē «AI aģents, kas strādā tavā vietā». Jo augstāks OSWorld, jo ticamāk, ka drīz vari palaist aģentu, kurš savāc informāciju no vairākām vietnēm, aizpilda tabulu, sakārto failus un sagatavo atskaiti. Skolotājam — aģents, kas savāc materiālus no vairākiem avotiem un saliek stundai. Uzņēmējam — aģents, kas apstrādā datus no vairākām programmām.
ScreenSpot — «redz ekrānu un nospiež pareizo pogu»
ScreenSpot (un tā Pro versija) pārbauda šaurāku, bet praktiski ļoti svarīgu prasmi: vai modelis, ieraugot datora ekrānu — lietotnes logus, pogas, izvēlnes — spēj klikšķināt uz pareizās vietas. Iedomājies «Atrodi lietu!» spēli, bet ar desmitiem pogu uz ekrāna: modelim jāpiedur pirksts tieši tai vienai. Tā ir pamateja visiem «AI, kas redz tavu ekrānu un dara» rīkiem.
«92,7» ir ļoti augsts rādītājs. Praksē tas nozīmē mazāk «AI noklikšķināja nepareizo pogu» kļūdu, kad izmanto ekrāna aģentus.
Terminal-Bench — «raksta un palaiž kodu terminālī»
Terminal-Bench novērtē modeļa spēju risināt programmēšanas un sistēmu uzdevumus reālā komandrindas (termināļa) vidē. Modelis nedrīkst tikai «pastāstīt, kā izdarīt» — atbilde nav teksts: tam jāieraksta komandas reālā terminālī un jāpierāda, ka tās nostrādāja. «Science» apakšvariants = zinātniskie programmēšanas uzdevumi (datu apstrāde, simulācijas).
«55,8 (Fable 5.1) pret 42,0 (Fable 5) pret ~37 (Sol)» — tā ir daļa atrisināto uzdevumu. Šis ir koda aģentu «šosejas tests».
Ko tas nozīmē tev: ja tu vai tavs izstrādātājs izmanto AI programmēšanai vai datu apstrādei — skaties uz Terminal-Bench / SWE-bench klasi. Ja programmēšana tevi neskar — vari droši izlaist.
SWE-bench — «atrod un salabo kļūdu īstā programmā»
Vēl viens programmēšanas etalons, bet ar būtisku atšķirību: tā ir kā automehāniķa eksāmens. Modelim iedod īstu kļūdas aprakstu no atvērtā koda projekta GitHub — līdzīgi kā «tur kaut kas negrab aizmugurē» — un modelim jāatrod, kas salūzis, jāuzraksta labojums un jāpierāda, ka testi iziet. Tas mēra nevis «spēj uzrakstīt koda gabaliņu», bet «spēj izsekot un saremontēt reālu problēmu» — krietni tuvāk tam, ko programmētājs dara katru dienu.
CyberGym — «atrod drošības caurumus»
CyberGym ir kiberdrošības etalons: kā slēgta «vingrinājumu telpa», kur modeli ielaiž sistēmās ar zināmiem caurumiem un vēro, cik daudz no tiem tas atrod (un dažkārt izmanto). To lieto no aizsardzības puses — lai noskaidrotu, cik labs modelis ir kā «automātiskais drošības skeneris», kas caurumus atrod PIRMS ļaundariem.
«86,2 % (Flash Cyber) par Flash cenu» ir ievērojami: ļoti lēts modelis tagad atrod ievainojamības gandrīz tikpat labi kā dārgākie.
Ko tas nozīmē tev: ja tavā uzņēmumā rūp IT drošība — šis rādītājs parāda, ka AI tagad var būt lētais «drošības konsultants». Bet atceries otro pusi: tas pats spēks, kas atrod caurumus aizsardzībai, atrod tos arī uzbrukumam. Tāpēc šos modeļus tur aiz «uzticamo aizstāvju» programmām, nevis atver katram.
Saliktie indeksi — «punkts no vairākiem testiem»
Ne viss ir procentos. Tādi rādītāji kā Artificial Analysis Intelligence Index apvieno vairākus atsevišķus testus un izsaka rezultātu vienā «punktu» skalā — līdzīgi, kā no vairākām atzīmēm izrēķina vidējo vai kā veido universitāšu reitingus. «61/62 punkti» ir salikts kopējais rādītājs, nevis kāda viena testa procents.
Praktiskie parametri — ko mēra ārpus «gudrības»
Šie skaitļi nav testa rezultāti, bet tavā ikdienā tie bieži sver vairāk.
Cena — dolāri par miljonu tokenu
Tokeni ir aptuveni «vārdu gabaliņi». Angliski 1000 tokenu ≈ 750 vārdi; latviski vārdi ir garāki un ar garumzīmēm, tāpēc tie «patērē» mazliet vairāk tokenu. Modeļu cenu parasti raksta kā «X $ / 1M ievades, Y $ / 1M izvades».
«10 / 50 $» (flagmanis) pret «0,75 / 3,75 $» (Flash) — atšķirība vairāk nekā desmit reizes. Ievade ir tas, ko tu raksti modelim; izvade — atbilde. Izvade parasti dārgāka, jo modelim «domāt» maksā vairāk nekā «lasīt».
Ja AI lieto katru dienu, cena ļoti ātri kļūst svarīgāka par punktiem.
Konteksta logs — cik daudz modelis «tur galvā»
Konteksta logs ir maksimālais teksta apjoms, ko modelis var redzēt vienā sarunā vienlaikus. «1M tokenu» ≈ 750 000 vārdu — tas ir aptuveni 7–9 vidēja garuma grāmatas. Tas nozīmē: vari iedot veselu grāmatu, dokumentu mapi vai ļoti garu sarunas vēsturi, un modelis to visu ņems vērā, atbildot.
Praktiski: analizējot garus dokumentus (mācību plānus, līgumus, garus rakstus), vajag LIELU kontekstu. Ātriem jautājumiem pietiek ar mazu.
MRCR — «cik labi atceras garās sarunās»
MRCR = multi-round context recall — «atcerēšanās vairākās sarunās kārtās». Pārbauda, vai modelis garās, daudzu jautājumu sarunās neaizmirst to, par ko runājāt sākumā. «98,5 % pie 1M tokeniem» nozīmē: pat ļoti garā sarunā gandrīz nekas nepazūd.
Ko tas nozīmē tev: ja ar AI strādā garās, daudzpakāpju sarunās — kopīgi raksti kursu, izstrādā stratēģiju vairāku dienu garumā — augsts MRCR nozīmē «mazāk jāatkārtojas».
Ātrums (latence)
Cik ātri nāk atbilde. «Flash» klases modeļi ir ātri; flagmaņi — lēnāki. Klientu servisa čatbotos, interaktīvos stundu rīkos ātrums ir kritisks. Dokumenta analīzei, kas iet pa nakti, — vienalga.
Populārākie modeļi — ātrais salīdzinājums
Stāvoklis 2026. gada septembrī. Skaitļi no mūsu dienas AI apskatiem — tie mainās ātri, tāpēc uztver šo kā momentuzņēmumu, nevis pastāvīgu patiesību.
| Modelis (izstrādātājs) | Cenu klase | Cena $/1M | Konteksts | Pazīstamākais rādītājs |
|---|---|---|---|---|
| GPT-6 Astra (OpenAI) | flagmanis | 10 / 50 | — | 99,9 ARC-AGI-3 · 97,6 % FrontierMath |
| Claude Fable 5.1 (Anthropic) | flagmanis | 10 / 50 | 1M | 55,8 Terminal-Bench 4.0 |
| GPT-5.6 Sol (OpenAI) | flagmanis (iepriekšējais) | — | — | ~7 ARC-AGI-3 |
| Grok 4.6 (xAI) | flagmanis (vidējais) | — | — | ~61 AI indekss |
| Muse Spark 1.3 (Meta) | «zibens», lēts | 1,25 / 4,25 | 1M | 61 AI indekss · 98,5 % MRCR |
| Gemini 3.8 Flash (Google) | «zibens», lēts | 0,75 / 3,75 | 1M | 54,9 HLE-Verified |
Divas īpašās kategorijas, kas «nesēž» vispārējā tabulā:
- Gemini 3.8 Flash Cyber (Google) — drošības variants: 86,2 % CyberGym par Flash cenu. IT drošības komandām, kas grib automātisku ievainojamību meklēšanu bez flagmaņa rēķina.
- Mythos 5.1 (Anthropic) — vispārējā piekļuvē nav; ierobežots kiberdrošības un dzīvības zinātņu partneriem.
Kā šo tabulu lasīt: flagmaņus (Astra, Fable 5.1) ņem, kad uzdevums ir grūts, rets un kļūdas cena augsta — dziļa analīze, sarežģīts rakstīšanas darbs. «Zibens» līniju (Flash, Spark) ņem ikdienai un aģentu ķēdēm, kur noteicošais ir ātrums un cena. Starp klasi un «zibens» cenu atšķirība ir vairāk nekā desmit reizes — un lielai daļai darbu «zibens» ir vairāk nekā pietiekami. (Vēl viena nianse: Gemini Flash intro cena 0,75 / 3,75 $ ir spēkā tikai līdz 2026. gada beigām, tad tā dubultojas — vērts par to zināt, kad plāno ilgtermiņa slodzi.)
Praktiskais kopsavilkums — kurš skaitlis izšķir tavam darbam
Biežākā kļūda ir pirkt «visgudrāko» modeli. Pareizāk ir saprast, ko TU šodien dari, un skatīties tikai uz to skaitli, kas šim darbam izšķir.
| Tavs reālais uzdevums | Izšķirošais parametrs | Piemērs / padoms |
|---|---|---|
| Uzrakstīt e-pastu, tekstu, stundas plānu | Cena + ātrums | Flash klase (0,75 $) dara to tikpat labi kā flagmanis (10 $) — nav jēgas pārmaksāt. |
| Analizēt garu dokumentu (līgums, standarts, grāmata) | Konteksta logs + MRCR | 1M logs = vari iedot visu vienā piegājienā; mazs logs → modelis «aizmirst» sākumu. |
| Ļaut aģentam pašam strādāt ar programmām (savākt datus, aizpildīt tabulu) | OSWorld + ScreenSpot | Augsts OSWorld = mazāk «nospieda nepareizo pogu». Pārliecinies, ka tavs uzdevums tiešām ir šis. |
| Rakstīt / labot kodu, apstrādāt datus (skripti, atskaites) | Terminal-Bench + SWE-bench | 55,8 (Fable 5.1) ir spēcīgs signāls; ja pats nekodē — izlaid. |
| Sarežģīta, neparasta loģika («īsta domāšana») | ARC-AGI + FrontierMath | 99,9 (Astra) pret 7 (Sol) — reāls lēciens, bet arī tad pārbaudi PATS. |
| Uzņēmuma IT drošība | CyberGym | Lēts Flash Cyber atrod ievainojamības — bet tikai kontrolētā aizsardzības vidē. |
Divas dzīvas ilustrācijas:
Skolotāja. Laila sagatavo stundas plānu par fotosintēzi 8. klasei. Viņai nevajag ARC-AGI 99,9 — vajag ātru un lētu modeli, bet, ja vēlas vienlaikus iedot vairāku avotu tekstus, arī lielu konteksta logu. Viņa ņem Flash klasi, nevis flagmani: stundas plāns būs tikpat labs, bet krietni lētāks un ātrāks.
Uzņēmējs. Jānis grib, lai AI katru rītu savāc pasūtījumu datus no trīs programmām un saliek vienā tabulā. Te izšķir OSWorld (vai aģents prot pareizi strādāt ar reālām programmām), nevis HLE. Viņš palaiž aģentu uz savas reālās plūsmas un skaita: ja 9 no 10 reizēm pareizi — laiž ražošanā; ja nē — meklē citu modeli vai vienkāršo uzdevumu.
Trīs brīdinājumi, pirms tici skaitlim
- Augsts skaitlis negarantē labas reālās spējas. Etaloni mēra šauri kontrolētu uzdevumu šķēli, un tos var «piespēlēt» — trenējot modeli uz pašiem testiem (tad skaitlis kļūst par reklāmu) vai nopulējot tieši to formātu, kurā mēra. Tāpēc labi etaloni (ARC-AGI, FrontierMath) uzdevumus tur noslēpumā — bet ne vienmēr izdodas, un līdz ar to «indeksa punkti» var būtiski atdalīties no tā, kā modelis patiesībā strādā tieši tavā uzdevumā.
- Nav viena «gudrības cipara». Katrs etalons mēra šauru šķēli. Modelis var būt labāks programmēšanā un vājāks dabiskā valodā — abi apgalvojumi vienlaikus ir patiesi.
- Labākais etalons esi tu pats. Neviens tests neaizstāj to, kā modelis darbojas tieši tavā uzdevumā. Iedod tam savu stundas plānu, savu e-pastu, savu klienta jautājumu — un skaties rezultātu. Tas ir «etalons», kuram nav nulles.
Piemērs no dzīves. Kad 2026. gada septembrī Meta izlaida Muse Spark 1.3, tā publicētie kodēšanas skaitļi izskatījās lieliski — bet neatkarīgie vērtētāji uzreiz norādīja uz diviem «āķiem». Pirmkārt, labākie rezultāti nāca no «max» režīma, kas palaišanas dienā izstrādātājiem vēl nebija pieejams (vēl drošības testēšanā), un salīdzinājums bija «max» pret iepriekšējās versijas «xhigh» — dažādi režīmi, nevis tīra paaudžu atšķirība. Otrkārt, pat Meta pašas tabulā modelis uzvarēja kodēšanas un garā konteksta testos, bet aģenta uzdevumos neuzvarēja nevienā no sešiem — lai gan paziņojums reklamēja lielāko lēcienu tieši aģentu darbā. Realitātē daļa izstrādātāju palika atturīgi: ātrs un lēts, bet darbā ne tik spējīgs, kā solīja skaitļi. Šim fenomenam pat ir vārds — benchmaxxing («punktu uzspodrināšana») — kad rādītājus «piešauj» testiem, nevis īstajam darbam.
Avoti: Laura Martel · VentureBeat · Towards AI
Nobeigums
Modeļu skaitļi nav tehniskā žargona dekorācija — tā ir vienīgā kopīgā valoda, kādā laboratorijas mēra viena otru. Kad saproti, ko kurš etalons mēra, AI ziņas pārvēršas no skaitļu putras par stāstu: «lēts un ātrs» tagad dzenas pakaļ «gudram», un atšķirību arvien vairāk izšķir nevis tas, cik punktu, bet — cik lēti, cik ātri un cik droši.
🧩 Pašpārbaude — mini krustvārdu mīkla
Četri jēdzieni no šī raksta, sakrustoti savā starpā. Izlasīji — tagad pārbaudi, vai atpazīsti tos pēc apraksta (atbildi raksti attiecīgajā rūtiņā).
| 1 | ||||||
| 2 | ||||||
| 3 | ||||||
| 4 | ||||||
Horizontāli:
– 3. AI «eksāmens» — uzdevumu kopa ar zināmām atbildēm (7)
– 4. Lētā un ātrā modeļu līnija (6)
Vertikāli:
– 1. Vecākais «57 priekšmetu» zināšanu tests (4)
– 2. Vārda gabaliņš, kurā mēra tekstu un cenu (6)